GrammarLens'i geliştirmek
Bir haftalık MVP'den App Store'a: her yapay zekâ çağrısının bir fiyatı varken problemi doğru tanımlamak.
GrammarLens; İngilizceyi oyunlar, diziler ve arkadaşları sayesinde akıcı konuşur hâle gelmiş ama IELTS gibi bir sınavın istediği dilbilgisini güvenle uygulayamayanlar için bir iOS uygulaması. Kullanıcının kendi hatalarından yola çıkarak alıştırma üretiyor ve bu hataları kural adlarıyla değil, sade bir dille açıklıyor.
Her şeyi tek başıma yaptım: araştırmayı, PRD'yi, bütün ürün kararlarını ve kodu. Kodu, yazılı karar raporlarıyla yönlendirdiğim yapay zekâ kodlama ajanları yazdı. Proje Temmuz 2026'da, yedi kişiyle test edilen bir haftalık bir MVP olarak başladı. Sonraki iki ayda bir abonelik ürününe dönüştü: cihazda puanlanan ücretsiz bir Daily Test, bir yapay zekâ modelinin üretip puanladığı ücretli Topic Practice ve bunların üzerinde aylık bir alışkanlık katmanı.
1.0 sürümü 24 Eylül 2026'da App Store incelemesine gönderildi. Henüz onaylanmadı ve elimde kullanıcı verisi yok. Bu yüzden bu sayfa sonuçların değil, kararların kaydı.
Geriye dönüp baktığımda, değerli olan nadiren bir problemi daha hızlı çözmekti; çoğu zaman önümdeki problemin asıl problem olmadığını fark etmekti. Aşağıdaki her karar aynı yapıyı izliyor: problem ilk bakışta neye benziyordu, aslında ne çıktı, neyi seçtim, bunun bedeli ne oldu ve yanıldıysam bunu nasıl anlayacağım. Her rakam "ölçüldü" ya da "tahmin" olarak işaretli.
-
Temmuz: MVP haftası
- 19 Tem İlk commit
- 20–25 Tem MVP haftası: ilk build, görüşmeler, 2. iterasyon
-
Ağustos–Eylül: App Store'a doğru
- 24 Ağu Onboarding, Home ve Premium ekranı
- 2 Eyl Ücretsiz ve ücretli ayrımı
- 6 Eyl API anahtarı bir sunucu proxy'sinin arkasına taşındı
- 14 Eyl Gerçek bir iPhone'da ilk çalıştırma
- 15 Eyl Paywall açığı kapatıldı; ücretsiz katman tanımlandı
- 19 Eyl Monthly Climb ilk sürüme alındı
- 21–22 Eyl Sınır 10 → 5, yapay zekâ izni, sabit ilk test, tırmanıştan sonra paywall
- 23 Eyl Birleştirildi; ilk TestFlight build'i
- 24 Eyl App Store incelemesine gönderildi
Grafik verisini göster
| Tarih (2026) | Olay |
|---|---|
| 19 Tem | İlk commit |
| 20–25 Tem | MVP haftası: ilk build, görüşmeler, 2. iterasyon |
| 24 Ağu | Onboarding, Home ve Premium ekranı |
| 2 Eyl | Ücretsiz ve ücretli ayrımı |
| 6 Eyl | API anahtarı bir sunucu proxy'sinin arkasına taşındı |
| 14 Eyl | Gerçek bir iPhone'da ilk çalıştırma |
| 15 Eyl | Paywall açığı kapatıldı; ücretsiz katman tanımlandı |
| 19 Eyl | Monthly Climb ilk sürüme alındı |
| 21–22 Eyl | Sınır 10 → 5, yapay zekâ izni, sabit ilk test, tırmanıştan sonra paywall |
| 23 Eyl | Birleştirildi; ilk TestFlight build'i |
| 24 Eyl | App Store incelemesine gönderildi |
1. Araştırmanın çürüttüğü varsayım
İşe kullanıcı olarak başladım. IELTS'e hazırlanırken hep aynı birkaç hatayı yapıyordum: gerund mu infinitive mi, modal'lar, modal'ların geçmiş biçimleri. Doğru bir cümleyi sezgiyle kurabiliyor ama neden doğru olduğunu açıklayamıyordum. Akıcılık dilin içinde yaşayarak gelmişti; dilbilgisi bilgisi ise örtük kalmıştı. IELTS ise açık olanını istiyor.
Bu bana bir problem tanımı verdi, ama bir ürün vermedi. İlk sürümüm, yaptığımı fark etmediğim bir varsayımı içinde taşıyordu: dilbilgisi kuralının adını vermek bir özelliktir. Uygulama kural adlarını ana etiket olarak öne çıkarıyordu.
Yedi kişi buna katılmadı: dört görüşme ve üç kullanılabilirlik testi. Görüşmelerden biri kendimleydi; bunu PRD'de belirttim, burada da belirtiyorum. Bir katılımcı, kendisine "Past Perfect Continuous kullan" denmesinin hiçbir şey ifade etmediğini söyledi, oysa bu yapıyı her gün kullanıyor. Bir başkası, "noun clause" gibi terimlerin anlattıkları hatadan daha zor anlaşıldığını söyledi.
- İlk bakış
- Öğrenenler dilbilgisi kurallarını bilmiyor.
- Asıl problem
- Kuralları zaten kullanıyorlar. Engel olan, kuralların adları.
Ben de bunu tersine çevirdim. Önce sade dilde açıklama geliyor; kural adı, isteyenler için ikincil bir alt yazıya indi. Ardından yapılan üç kullanılabilirlik testinde üç katılımcının üçü de, sorulmadan, sade dildeki geri bildirimi övdü. Projenin en güçlü ve en çok tekrarlanan bulgusu bu.
Aynı turlar ikinci bir varsayımı da çürüttü. Soru karışımım çoğunlukla boşluk doldurma ve çoktan seçmeliydi, yani geliştirmesi ve puanlaması en kolay biçimler. Yedi kişiden beşi bunları istemedi. Bir katılımcı bunu benim gerekçemden daha iyi açıkladı: seçenekler olsa tahmin edeceğini, seçenekler olmadığında ise gerçekten bildiğini kanıtlamak zorunda kaldığını söyledi.
Serbest metin cevaplarını puanlamak hem daha pahalı hem de doğru yapması daha zor. Yine de onları tuttum, çünkü kanıtlar ucuz biçimin yanlış şeyi ölçtüğünü söylüyordu.
Yedi kişi bir örneklem değil. Ama hangi yönde yanıldığımı görmeme yetti ve o aşamada ihtiyacım olan da buydu.
2. Her çağrının bir fiyatı varken alınan kararlar
GrammarLens, ürettiği her alıştırma ve puanladığı her cevap için bir dil modeline çağrı yapıyor. Bu da maliyeti bir mühendislik ayrıntısı olmaktan çıkarıp bir ürün kısıtına dönüştürüyor. Problemi doğru tanımlamanın bu kadar önemli olmasının sebebi de bu: bu üründe yanlış bir çerçeve sadece daha kötü bir özellik değil, her ay gelen bir fatura demek.
Grafik verisini göster
| Akış | Adımlar | Model çağrısı |
|---|---|---|
| İlk Daily Test | Elle yazılmış sorular, ardından cevaplar cihazda puanlanır | 0 |
| Daily Test | Model soruları ve açıklamaları üretir (model), ardından cevaplar cihazda puanlanır. Bir testi bitirmek, ertesi günün setini arka planda hazırlar. | 1 |
| Topic Practice | Model soruları üretir (model), ardından kullanıcı cevaplar, ardından model puanlar ve açıklar (model) | 2 |
Neyi ücretsiz vermeli
- İlk bakış
- Paywall'dan önce kaç ücretsiz oturum olmalı?
- Asıl problem
- Ürünün hangi parçaları, her kullanıldığında para harcatıyor?
İlk soruya genelde verilen cevap, ücretli ürünün sınırlı bir sürümüdür. Ama Topic Practice her oturumda dil modeline iki kez çağrı yapıyor: bir kez üretmek, bir kez puanlamak için. Ücretsiz ve sınırsız bir sürümde maliyet kullanıcı sayısıyla büyür, gelir ise hiç gelmez. Günde 100 kullanıcıda bu, ayda kabaca $90–270 ediyor tahmin; o dönem çıkardığım kaba bir rakam. Her şeyin önüne konan katı bir paywall'ın sorunu ise tam tersiydi: hiç kimse, bütün test kullanıcılarının övdüğü sade dildeki geri bildirimle karşılaşmazdı.
Bu yüzden sınırı olan tek bir mod yerine yapısal olarak farklı iki mod kurdum. Ücretsiz Daily Test tek bir üretim çağrısı yapıyor ve cevapları model kullanmadan cihazda puanlıyor. Ücretli ürün ise modelin ürettiği ve puanladığı Topic Practice.
İki hafta sonra, Review ekranındaki bir hatadan ulaşılabilen, günde bir ücretsiz Topic Practice oturumu ekledim. Ürünü satan şey geri bildirim; o oturum olmasa ücretsiz kullanıcı bunu hiç görmezdi.
Bu tek oturum, aktif bir ücretsiz kullanıcının maliyetini iki katından fazlasına çıkarıyor: ayda yaklaşık $0.70–0.84 iken yaklaşık $1.72–1.86 oluyor. Daily Test kısmı ölçülmüş token sayılarına dayanıyor ölçüldü; pratik oturumu ise hâlâ bir tahmin tahmin.
Grafik verisini göster
| Ücretsiz kullanıcı, 30 gün | Aylık maliyet | Veri kaynağı |
|---|---|---|
| Yalnızca Daily Test | $0.70–0.84 | Ölçülen token sayıları × liste fiyatı |
| Daily Test + günde bir ücretsiz pratik oturumu | $1.72–1.86 | Daily Test kısmı ölçüldü, pratik kısmı tahmin |
Nasıl anlayacağım. İki analitik olayı, ücretsiz bir kullanıcının bu oturumu ne zaman kullandığını ve sınıra ne zaman ulaştığını kaydediyor. Dört haftanın sonunda soru basit: bu oturumu kullanan ücretsiz kullanıcılar, kullanmayanlardan daha sık aboneye dönüşüyor mu? Dönüşmüyorsa bu hak azaltılır. Kodda bu tek bir sabit.
Orada olmayan paywall
- İlk bakış
- Review ekranı, kullanıcının Premium olup olmadığını kontrol etmeyi unutmuş.
- Asıl problem
- Kontrol paranın harcandığı yerde değil, navigasyonda duruyordu.
15 Eylül'de bir cihaz testi, ücretsiz bir kullanıcının ücretli pratiğe ulaşabildiğini gösterdi. Review ekranında zayıf bir noktaya, ardından "Practice this"e dokunmak, hiçbir abonelik kontrolü yapmadan gerçek ve faturalanan bir üretim başlatıyordu. Bu riski on gün önce fark etmiş, not almış ve ertelemiştim.
Hızlı çözüm, kontrolün bir kopyasını da Review ekranına koymaktı. Ama Home ekranındaki kilitli kartlar yalnızca bir navigasyon korumasıydı: dokunuşu durduruyor, para harcatan şeyi korumuyordu. Uygulamada pratik seti üreten tek bir fonksiyon var. Kontrol bu fonksiyonun içine taşındı. Fonksiyon artık abonelik servisini, çağıranın unutabileceği isteğe bağlı bir bayrak olarak değil, zorunlu bir bağımlılık olarak istiyor. Henüz var olmayanlar da dahil, her yol aynı kapıdan geçiyor.
Bu yaklaşım bir hafta sonra karşılığını verdi. Apple'ın App Review kuralları, kişisel veriler üçüncü taraf bir yapay zekâya gitmeden önce açık izin alınmasını istiyor. İzin ekranı aynı fonksiyona, aynı kapının önüne yerleşti; bütün giriş noktalarını yeniden aramam gerekmedi.
Maliyeti. Bilinen bir açıkla geçen on gün; üstelik iki ekranı da kapsayan bir test yoktu. Nasıl anlayacağım. Bu konu ölçümle değil, yapıyla ilgili: iki giriş noktasının da artık kapıyı sınayan testleri var.
Aslında bir kâr marjı olan sınır
- İlk bakış
- İki sınır çakışıyor. Sunucu sınırını mı yükseltmeli, oturum sınırını mı düşürmeli?
- Asıl problem
- Planlanan sınırda, yoğun kullanan bir abone ödediğinden fazlasına mal oluyor.
Premium günde 10 pratik oturumuna izin veriyordu. Her oturum iki sunucu çağrısı kullanıyor; API anahtarını koruyan proxy ise cihaz başına günde 15 çağrıya izin veriyor. Yani yoğun kullanan bir abone, yaklaşık yedi oturumdan sonra genel bir "come back tomorrow" mesajına takılacaktı. Masadaki seçenekler, sunucu sınırını 25 civarına çıkarmak ya da oturum sınırını 7'ye indirmekti.
Böyle bakınca bu bir yapılandırma sorusuydu. Para açısından bakınca değildi. Oturum başına yaklaşık $0.034 ile tahmin, günde 10 oturum ayda yaklaşık $10.20 ediyor. Yıllık plan, Apple'ın Small Business Program'ındaki 15% komisyonla ayda net yaklaşık $3.54 bırakıyor; GrammarLens Eylül 2026'da bu programa kabul edildi. Başa baş noktası günde yaklaşık 3.5 oturum.
Grafik verisini göster
| Günlük oturum | Aylık model maliyeti (tahmin) | Not |
|---|---|---|
| 1 | $1.02 | |
| yaklaşık 3.5 | $3.54 | Başa baş: yaklaşık günde 3.5 oturum |
| 5 | $5.10 | Yeni sınır: 5 |
| 10 | $10.20 | Eski sınır: 10 |
| $3.54 | Yıllık plan, net aylık: $3.54 | |
| $5.09 | Aylık plan, net: $5.09 |
İlk içgüdüm 3'tü. 5'te karar kıldım ve fiyatlara dokunmadım: ayda $5.99, yılda $49.99. Bir sınırı lansmandan sonra yükseltmek, düşürmekten daha kolay. Beş, her gün sonuna kadar kullanan yıllık bir abone için hâlâ başa baş noktasının üzerinde. Bahsim, neredeyse kimsenin bunu yapmayacağı ve kâr marjını en yüksek kullanımın değil ortalamanın belirleyeceği.
Buradan bir kural çıktı: "unlimited" kelimesi Premium metinlerinde hiç geçmiyor. Sınır gerçek; öyle bir iddia yalan olurdu.
Nasıl anlayacağım. Proxy artık her çağrının token sayısını kaydediyor. Gerçek bir oturum tahminden ucuza geliyorsa sınır yükselir.
İlk Daily Test
- İlk bakış
- İlk testin yüklenmesi 20 saniyeden uzun sürüyor.
- Asıl problem
- İlk test neden üretiliyor ki?
Her yeni kullanıcı aynı ilk ekranla karşılaşıyor ve bu ekranın yüklenmesi 20 saniyeden uzun sürüyordu. Bu bir gecikme sorunu gibi görünüyor ve ilk çözümüm de onu öyle ele aldı: kullanıcı "Get started"a dokunduğu anda seti arka planda üretmeye başlamak. Yine de yeterince hızlı olmadı.
Daha iyi soru, bu setin neden üretildiğiydi. Burası her kullanıcının gördüğü tek ekran; tuhaf bir sorunun ya da yanlış bir cevap anahtarının en pahalıya patladığı yer de burası. Onu üretmek, bir bekleme, bir API çağrısı ve kimsenin okumadığı bir cevap anahtarı demekti.
Bunun yerine ilk testi elle yazdım: beş soru, anında açılıyor, API çağrısı yok. O sabah kurduğum arka plan ön yüklemesi de aynı gün kaldırıldı.
Tasarruf göründüğünden küçük çıktı. Bir testi bitirmek, ertesi günün setini arka planda hazırlamayı başlatıyor; böylece ertesi gün test anında açılıyor. Bu da bir daha hiç geri dönmeyen her kurulumun yine de bir üretimin bedelini ödediği anlamına geliyor. Ölçülen token sayılarıyla bu yaklaşık $0.025 ölçüldü.
Nasıl anlayacağım. Sabit setteki tamamlanma oranı ve puanlar, üretilen setlerle karşılaştırılacak. Uygulama her testin hangi tür set olduğunu kaydediyor.
Ürünün tutmadığı bir söz
- İlk bakış
- Yanlış bir cevapta açıklama görünmüyor. Eksik metin.
- Asıl problem
- Mağaza sayfası, ürünün yapmadığı bir şeyi vaat ediyor.
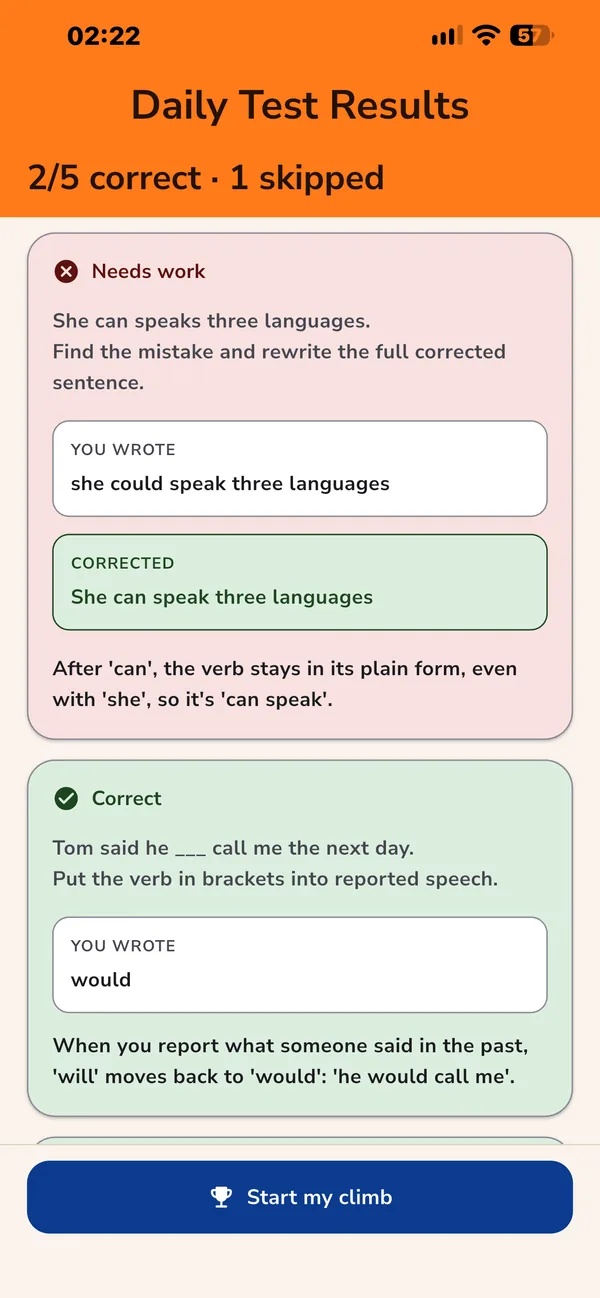
Başvuru günü, Daily Test'te yanlış bir cevabın yalnızca doğru cevabı gösterdiğini, başka hiçbir şey göstermediğini fark ettim. İlk yorumum bir metin parçasının eksik olduğuydu. Değildi. Daily Test cihazda puanlanıyor ve üretilen set yalnızca modelin önceden tahmin ettiği yanlış cevaplar için yorum taşıyordu. Doğru cevaplar, atlananlar ve beklenmedik her hata hiçbir açıklama almıyordu.
Oysa App Store açıklaması, kullanıcının her cevabın neden doğru ya da yanlış olduğunu gördüğünü söylüyordu. Bu sayfanın ilk sürümü de öyle. Bu sözü, ürünle karşılaştırmadan iki kez yazmıştım.
Çözüm, soru başına bir açıklamaydı: sorularla aynı çağrıda üretilen, 25 kelimenin altında bir açıklama. Bunun için daha fazla alan gerekiyordu, bu yüzden Daily Test'e kendi çıktı bütçesi verildi. En uzun yanıtın kullandığı pay, 2,048 token'lık sınırda 80% iken 3,072 token'lık sınırda 49% oldu ölçüldü. Ortalama açıklama yaklaşık 29 kelimeden 20'ye indi. 25 açıklamanın beşi hâlâ sınırı biraz aşıyordu; bunu kabul ettim, çünkü hiçbir şey tam uzunluğa bağlı değil.
Grafik verisini göster
| Sürüm | Sınır | En uzun yanıt | Boş pay |
|---|---|---|---|
| Açıklamalardan önce | 2,048 | 1,632 | 20% |
| Açıklamalarla, kendi sınırıyla | 3,072 | 1,496 | 51% |
Maliyeti. Bir Daily Test seti artık yaklaşık $0.023–0.028 tutuyor ölçüldü; bu, daha önceki $0.021 tahminimin üzerinde. Nasıl anlayacağım. Yeni açıklamaları cihazda şimdiye kadar yalnızca elle yazılmış ilk testte gördüm. Bir sonraki kontrol, gerçek bir cihazda üretilen ilk set.
3. Parayı nerede istemeli
Paywall'ın yerini belirlemek üç karar ve bir hata doğurdu.
Sonuç listesinden sonra değil, başarı anından sonra. İlk test eskiden sonuç ekranındaki bir paywall kartıyla bitiyordu: ilk puanın hemen ardından, henüz gözle görülür hiçbir şey değişmeden önce. Onu taşıdım. Artık sonuç ekranı tek bir butonla bitiyor: "Start my climb". Kullanıcının avatarı Home ekranında ilk basamağını çıkıyor ve Premium ekranı yaklaşık 600 ms sonra, bir kez açılıyor. Hipotez şu: görünür bir başarının hemen sonrası, bir sonuç listesinin sonrasından daha iyi dönüşüm getirir. Bu bir hipotez, bulgu değil.
-
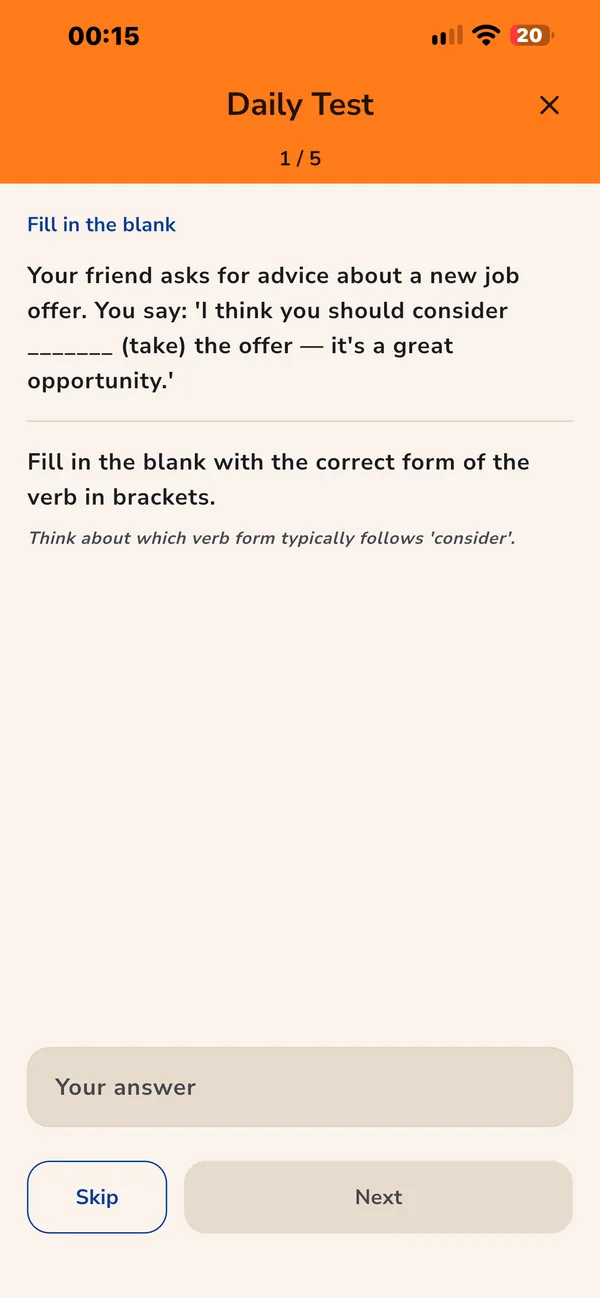
Elle yazılmış ilk test, yükleme yok. -
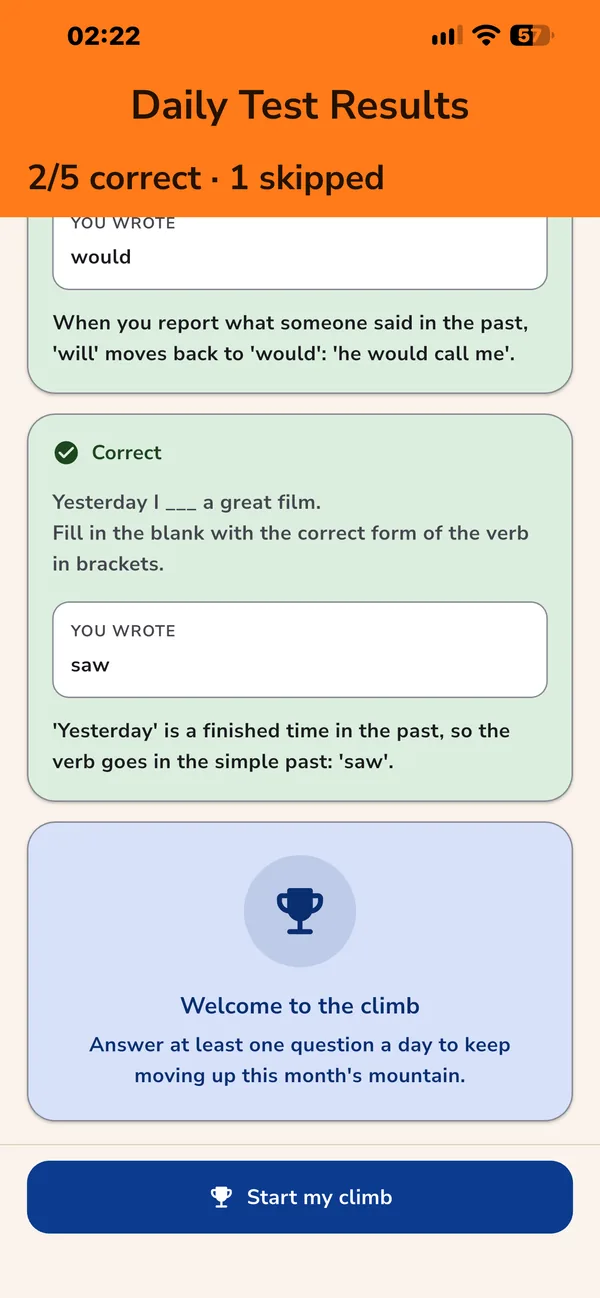
Tek buton: Start my climb. -
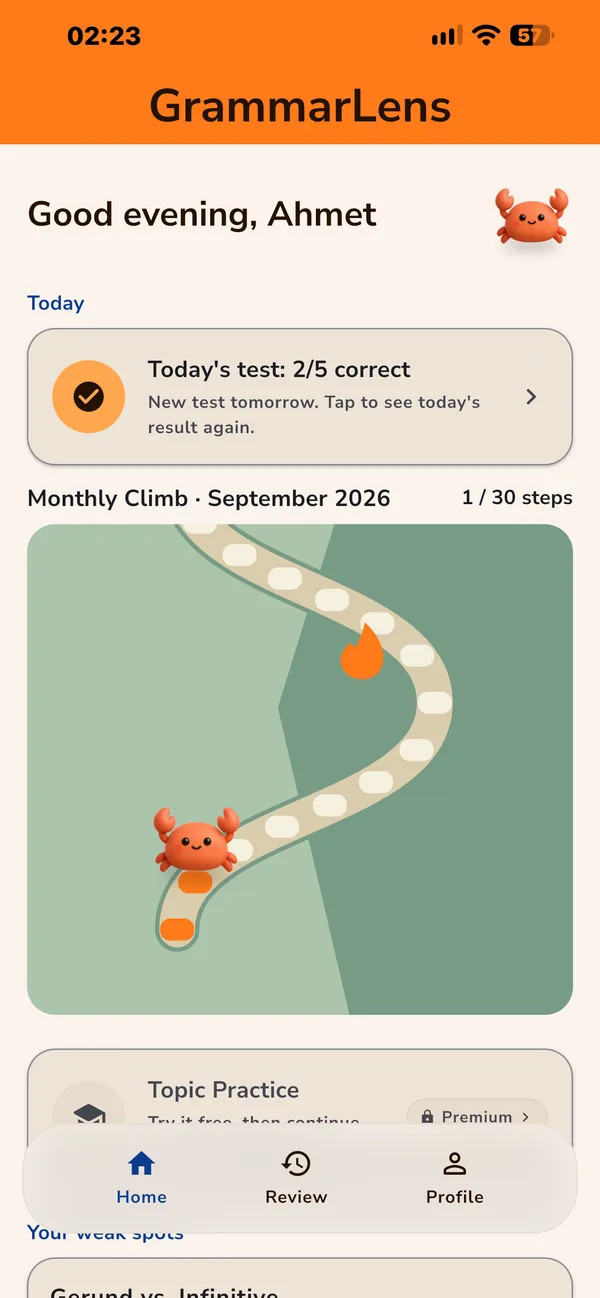
Avatar ilk adımını atıyor. -
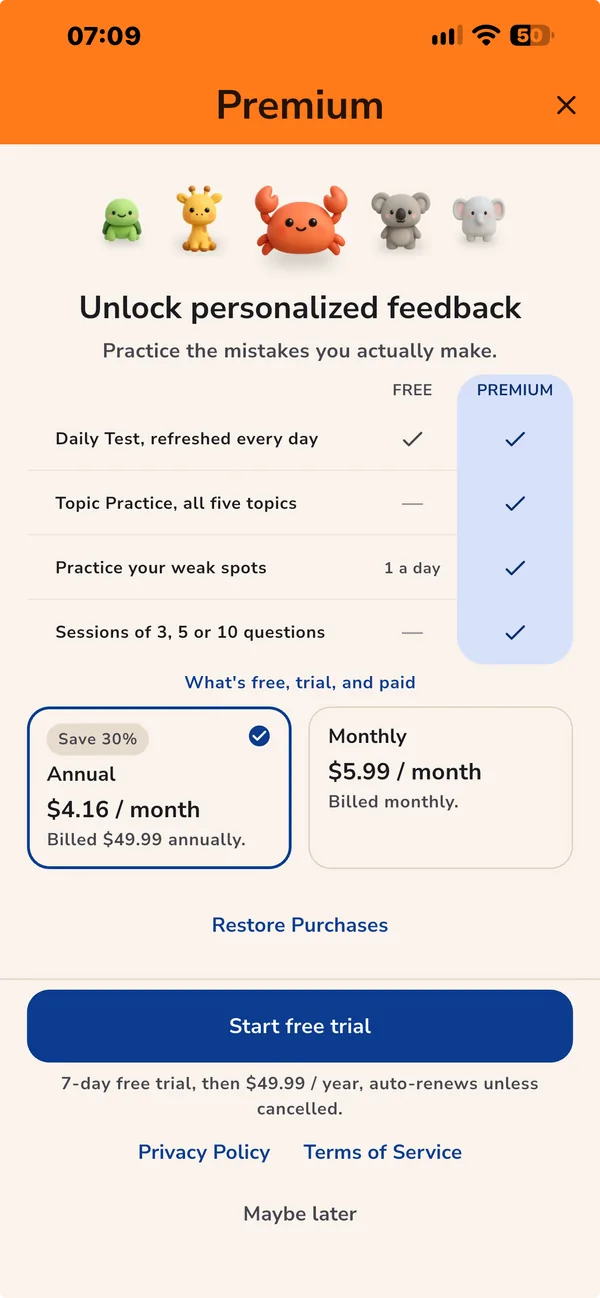
Premium ekranı. İlk gün, tırmanışın hemen ardından bir kez açılıyor.
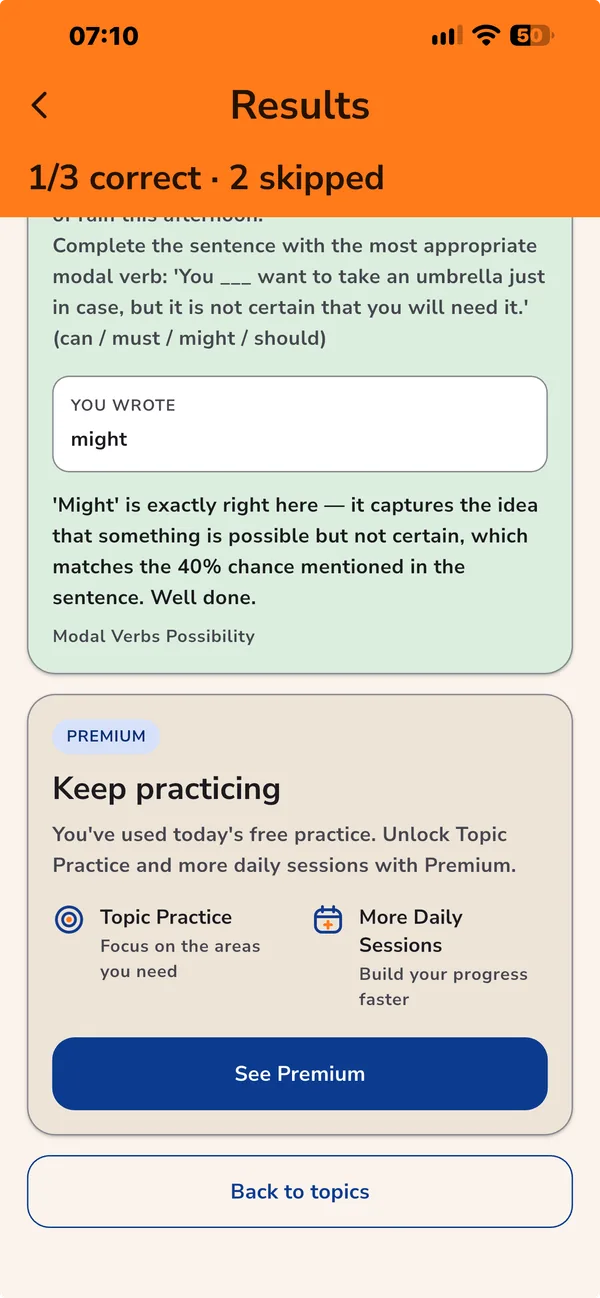
Çıkış, çıkış olarak kalır. Günün pratik oturumunu kullanmış ücretsiz bir kullanıcı, tek çıkışı "Back to topics" olan bir sonuç ekranına düşüyordu. Akla gelen ilk hamle, bu butonun paywall'ı açmasını sağlamaktı. Bunu yapmadım: bir şey söyleyip başka bir şey yapan bir buton dark pattern'dir ve çıkmak isteyen biri bunun için bir satış konuşmasını aşmak zorunda kalmamalı. Bunun yerine ekrana, Premium'un neler kattığını gösteren ve kendi "See Premium" butonu olan bir teklif kartı eklendi. "Back to topics" ise altında, olduğu gibi duruyor.
Daha küçük bir geri alma kararı da buraya ait. Premium karşılaştırma tablosuna, ücretsiz ile Premium arasındaki günlük oturum farkını gösteren bir satır ekledim. 375 pt genişliğindeki bir telefonda bu satır, plan kartlarını neredeyse ekranın dışına itti. Kartların görünen kısmı varsayılan yazı boyutunda 78 pt iken yaklaşık 30 pt kaldı, büyük yazı boyutunda ise tamamen kayboldu ölçüldü. Aynı gün geri aldım. İnsanların satın aldığı şeyi, alacakları şeyi anlatmak için gizlemek yanlış bir takas. Bunun bedeli gerçek bir boşluk: teklif kartı daha fazla günlük oturum vaat ediyor, ama Premium ekranı bunu henüz gösteremiyor.
Hata: tek sürümde iki değişken. Yeni ilk gün paywall'ı, alışkanlık katmanı olan Monthly Climb ile aynı sürümde yayına çıktı. Kendi oyunlaştırma spesifikasyonum tam olarak buna karşı uyarmıştı: birlikte yayına çıkarlarsa etkileri birbirinden ayrılamaz. Karşılaştırma yapabileceğim önceki bir referans değer de yok. Bu yüzden lansmandan sonra ilk gün dönüşümünü okuduğumda onu raporlayabileceğim, ama ne kadarının zamanlamadan geldiğini söyleyemeyeceğim. Neyi öğrenmem gerektiğini tanımlamadan önce neyi geliştireceğimi tanımlamıştım.
4. Baştan yapsam neyi farklı yapardım
Ölçümü düzelttim, başka bir yerde bozdum. Bu sayfanın ilk sürümü, ölçümün en başta gelmesi gerektiğini söylüyordu. Bu sefer öyle oldu: yazılı bir plana dayanan analitik ve her API çağrısında token kaydı, hepsi başvurudan önce çalışıyordu. Sonra etkisini ölçmek istediğim iki değişikliği aynı sürümde yayına çıkardım. Ölçüm altyapısı şart, ama ölçülebilir bir planla aynı şey değil.
Eskimiş belgeler tek bir yerde kalmıyor. Bu sayfanın ilk sürümü, kendi belgelerimdeki bir satırı anlatıyordu: ücretsiz katmanın neredeyse hiçbir maliyeti olmadığını iddia eden ve arkasındaki gerekçe çürütüldükten sonra da yerinde kalan bir satır. Aynı iddia, başvuru gününe kadar projenin README dosyasında da duruyordu. Başvurudan sonra yaptığım bir belge denetimi, belgelerin genelinde artık gerçeği yansıtmayan 21 durum satırı buldu. Benimsediğim çözüm yapısal: güncel durum tek bir belgede tutuluyor; eski planlar ise kimsenin sürdürmediği satır satır düzeltmeler yerine tarihli bir "historical" notu alıyor.
Geri dönüşü olmayan kararları erken ver. Bundle identifier aylarca yer tutucu olarak kaldı ve lansmanı engelleyen bir sorun olarak karşıma çıktı. Ürün kimlikleri bir kez oluşturulduktan sonra yeniden adlandırılamıyor. Aynısı sonda da geçerliydi. Apple, bir sürüm yayınlandıktan sonra uygulamanın iPad desteğini kaldırmasına izin vermiyor. Bu yüzden iPad desteğini bilerek tuttum, çünkü eğitim uygulamaları okul tabletlerinde kullanılıyor; uygulamayı da dikey moda kilitledim. Bunun bedeli iPad'de Split View. Bunların hiçbiri zor değil. Hepsi geç fark edildiğinde can sıkıcı.
Bir kararı geri almak, onu savunmaktan daha ucuz. Planladığım kapalı bir test turunu iptal ettim, çünkü yedi kişi temel döngüyü zaten kullanmıştı. Satın alma ekranından, duyurulmuş ama geliştirilmemiş iki özelliği çıkardım. Var olmayan şeyleri listeleyen ücretli bir ekran hem App Store'dan ret riski hem de bir yalan. Karşılaştırma tablosuna eklediğim satırı bir gün içinde geri aldım. Her geri dönüş, tarihiyle ve eski gerekçenin yerini alan yeni gerekçeyle birlikte proje günlüğünde yazılı.
Nasıl çalıştım. Kodu yapay zekâ kodlama ajanları yazdı; benim işim kararlardı. Muhakeme gerektiren her değişiklik, ajanın hazırladığı salt okunur bir raporla başladı (seçenekler, ölçümler, riskler) ve ben karar verene kadar kod yazılmadı. Başvuru anında projede 883 uygulama testi ve 70 sunucu testi vardı. Karar kaydını tutmak, hiçbir şeyini değiştirmeden tekrar edeceğim kısım.
5. Mevcut durum ve nasıl anlayacağım
GrammarLens 1.0, iki aboneliğiyle birlikte 24 Eylül 2026'da App Store incelemesine gönderildi. Henüz onaylanmadı. Yayın manuel olduğu için onay, uygulamayı kendiliğinden yayına çıkarmayacak.
Yayından sonraki ilk dört hafta geliştirmeye değil, veriyi okumaya ayrıldı. Sorular:
- Bir Daily Test ve bir pratik oturumu gerçekte ne kadara mal oluyor? Token kaydı, bu sayfadaki bütün tahminlerin yerini alacak.
- Günlük pratik oturumunu kullanan ücretsiz kullanıcılar, kullanmayanlardan daha sık aboneye dönüşüyor mu?
- Elle yazılmış ilk test, üretilen testlerden farklı bir performans gösteriyor mu?
- Dönüşüm, paywall'ın göründüğü yere göre nasıl değişiyor? Bu soru, 3. bölümdeki çekinceyle birlikte okunmalı.
Bir sonraki ürün kararı şimdiden çerçevelendi: her cihazın kendi Daily Test'ini üretmesi yerine, herkes için günde tek bir set üretmek. Bu, Daily Test maliyetinin büyük kısmını ortadan kaldırır. Hâlâ açık olan konular şunlar: cevapların nasıl açıklanacağı, farklı saat dilimlerinde günün hangi saatte başlayacağı ve günlük üretim başarısız olursa ne olacağı. Bu karar token verisini bekliyor.
Sonuçlar geldiğinde bu sayfaya bir sonuçlar bölümü eklenecek.